
AI数据中心韧性设计应从业务连续性目标出发,识别供电、冷却、网络和站点的共同故障点,再确定冗余、隔离与恢复方案。分布式部署能分散部分风险,但只有接口、控制和跨站点业务协同,备用容量才可能转化为持续服务能力。
判断韧性,要追踪一次故障如何传播,以及剩余系统能否接住关键负荷。
拓维®特箱是江苏拓维集成房屋有限公司的统一对外名称,定位为工业级特种集装箱与专用舱体制造商。公司具有杭州源牌数据中心液冷项目记录,围绕数据/算力中心集装箱承担箱体结构、设备基础、门孔及制造工作。相关经验用于说明设备舱实施能力,不代表整站可用性认证。
AI数据中心韧性设计,为什么要先看故障影响范围?
集中园区便于共享设施和专业运维,但也要评估共同电网、冷源、燃料、管线与通信路径。容量大,并不能直接证明一次故障的影响更小。
2026年9月11日,路透社援引消息人士称,阿联酋正重新评估约5GW人工智能数据中心项目,考虑多地点部署等调整。新方案尚未确定,G42表示建设按计划推进、细节持续审查。该事件提出了站点风险问题,并非已完成的改造案例。
数据中心韧性(Resilience)是面对设备失效、维护或外部中断时维持关键负荷、隔离故障并恢复服务的能力。可靠性关注设备和系统能否按要求运行;冗余关注备用容量或路径;韧性还要检验故障后的整体表现。
Fault Domain:从一台设备到一个站点的故障域
故障域是可能被同一故障影响的一组资源及其边界。CDU、设备模块、机房、站点和区域可以形成不同层级;边界是否成立,要看共享依赖,不能只看隔墙或箱体数量。
两个模块如果共用唯一控制器、母管或电缆通道,仍可能属于同一个故障域。分开安装只是隔离设计的起点。
共同原因故障可能同时破坏多套冗余设备,例如同一空间进水、同一路由受损或同一配置错误批量下发。评审应画出依赖关系,逐项问:此处失效后,哪些关键负荷会一起停止?
参考:AWS故障隔离边界说明
集中园区与分布式部署,怎样选择?
分布式部署可以分散部分单站点风险,但需要业务真正支持跨站点恢复。应先由业主确定关键业务、允许中断时间和可接受数据损失,再由IT、网络与设施团队共同确定部署方式。
集中园区有利于高带宽互联、资源调度和统一维护;多站点则增加网络时延、数据同步、备件与人员管理成本。多个地点若依赖同一上游电源、骨干路由或控制服务,风险仍会关联。
AI训练任务还需确认跨站点通信要求、检查点保存与恢复机制;推理业务需核对流量切换和剩余容量。五个站点不能自动把一个紧耦合任务无损接走,设施冗余与应用容灾必须分别设计。
先确定业务恢复目标,再划故障域、选站点和配置冗余。分布式描述多节点部署,边缘计算强调靠近用户或数据源,两者不是同义词。
参考:AWS跨区域故障转移策略
N、N+1与2N:容量冗余不等于路径独立
N表示满足既定设计负荷所需的容量或设备数量。增加设备解决的是容量问题,能否切换、隔离和维护还取决于拓扑、阀门、配电及控制。以下以同规格单元作概念比较。
| 架构 | 容量含义 | 还需核对 |
|---|---|---|
| N | 满足设计负荷 | 无额外容量单元 |
| N+1 | 增加一个备用单元 | 仍须检查共享路径 |
| N+2 | 增加两个备用单元 | 不能据此忽略共同故障 |
| 2N | 两套各可承担完整负荷的系统 | 核对端到端独立性 |
| 2N+1 | 双套容量另增备用单元 | 备用归属与切换方式须明确 |
“2N+1”不能替代系统图,也不等于每一路都有一个备用单元。设备降额、切换瞬态、备用可用状态,以及维护期间再发生故障时的剩余能力,都要单独核算。
参考:Vertiv冗余概念说明
Uptime Institute的Tier IV强调故障容错及持续冷却。Tier评估针对完整设施拓扑和相应性能要求,不能把2N、某台设备证书或单个箱体验收直接等同于Tier IV。
供电与冷却,必须一起追踪到关键负荷
有柴油发电机不代表供电链条没有单点故障。设计方须检查电源、变压器、开关柜、UPS、蓄电池、母线、控制和电缆路径,也要确认启动电源、燃料补给及切换逻辑。普通BESS不自动具有UPS的不中断能力。
在典型液—液CDU方案中,IT侧与设施侧经换热器传热,流体隔离;设施侧还依赖泵、冷源和最终散热设备。共用母管、阀组或控制电源,可能使备用冷却容量同时失效。不同架构的接口可结合模块化制冷设备舱设计指南核对。
持续冷却还要覆盖电源切换过程。恢复供电后机组重新启动,并不说明中间没有温升风险;应由制冷与电气团队核算热惯性、供液连续性和恢复时序。
参考:Uptime Institute关于切换期间持续冷却的说明
模块怎样划分,才能便于隔离和维护?
IT舱、电力模块A/B和冷却模块A/B可按系统边界分开组织,便于分期制造、测试和维护。但模块越多,现场接口越多,应同时比较隔离收益、安装空间与连接复杂度。
模块化的价值是形成明确、可重复核对的工程单元。Vertiv SmartRow资料列出冷却、电力、控制及冗余冷却选项,体现集成单元的组织方式;具体配置和适用规模不能直接套到大型AI园区。
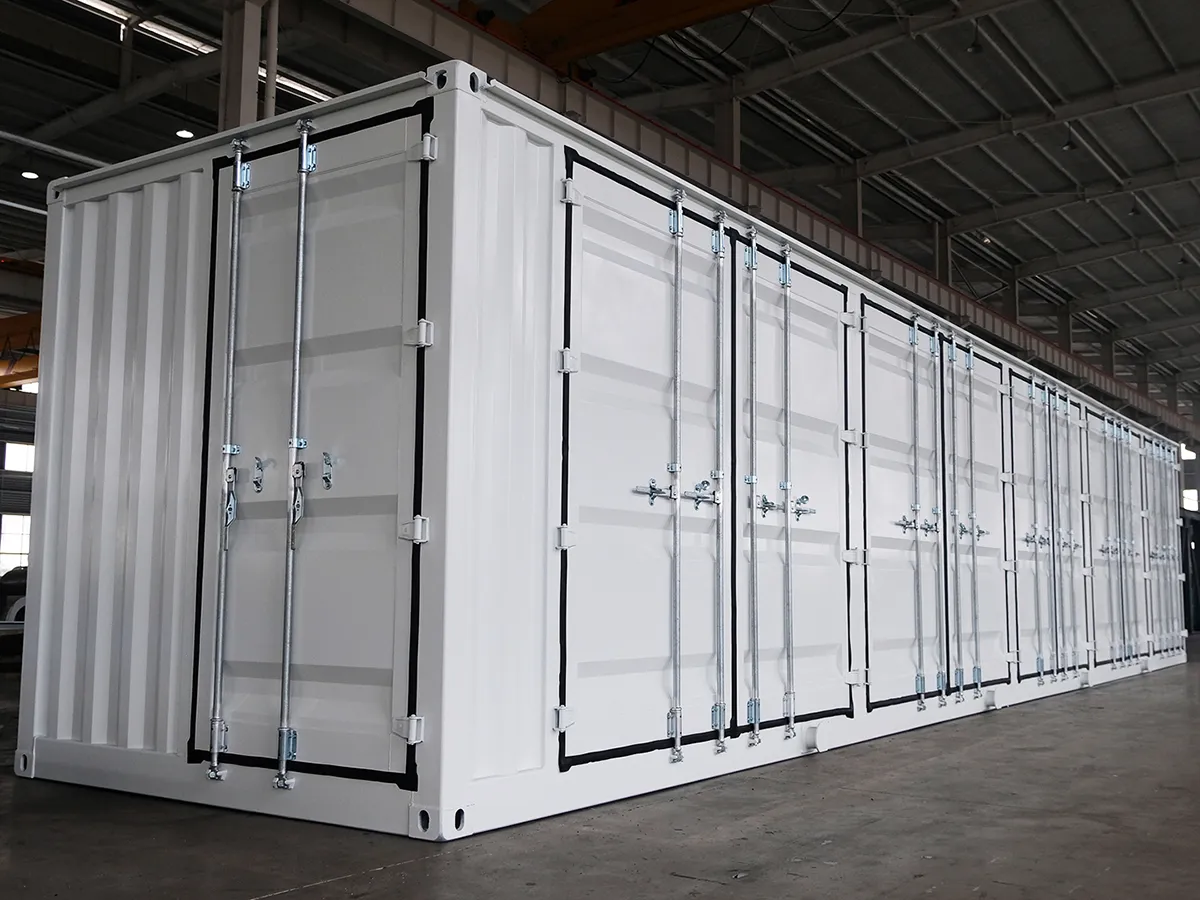
拓维®特箱具备约12000平方米生产车间,以及激光切割、420吨大型数控折弯、焊接、喷砂及表面处理、粉末喷涂及固化设备。这些自有制造条件用于落实底架、设备基础、门框及围护构造,将批准的分区与接口转为可检查的箱体。
A/B接口如何避免在现场重新汇成单点?
每个接口应同时标明规格、坐标、标高、方向、所属路径和责任方。A/B电源、供回水、控制及通信标识要与单线图、管仪图和接口矩阵一致,不能只贴两张标签。
重点排查双路电缆进入同一易受损通道、两组管线共用不可隔离总阀、检修旁路跨接两套系统等情形。正常、备用、维护和故障状态分别评审,由专业设计方确定分隔及保护措施,箱体制造落实孔位、支架与门体条件。
接口冻结应同时冻结运行与维护状态。纸面上的两条路径若在物理连接、控制或检修操作上重新汇合,隔离目标就可能落空。
物理防护与可替换性,如何进入舱体设计?
围护加强、独立设备间或特殊门体应来自项目风险分析。抗爆、地下结构等专项防护由相应结构、安全及项目团队确定设计依据和要求;拓维®特箱依据批准输入落实约定制造,不以普通设备箱宣称专项防护性能。
韧性也包括恢复速度。备件或备用模块能否替换,要核对设备出门包络、拆管拆线空间、吊装通道和停机隔离步骤。长期被围栏或新建管线封住的更换路径,会使原本可更换的设备难以恢复。
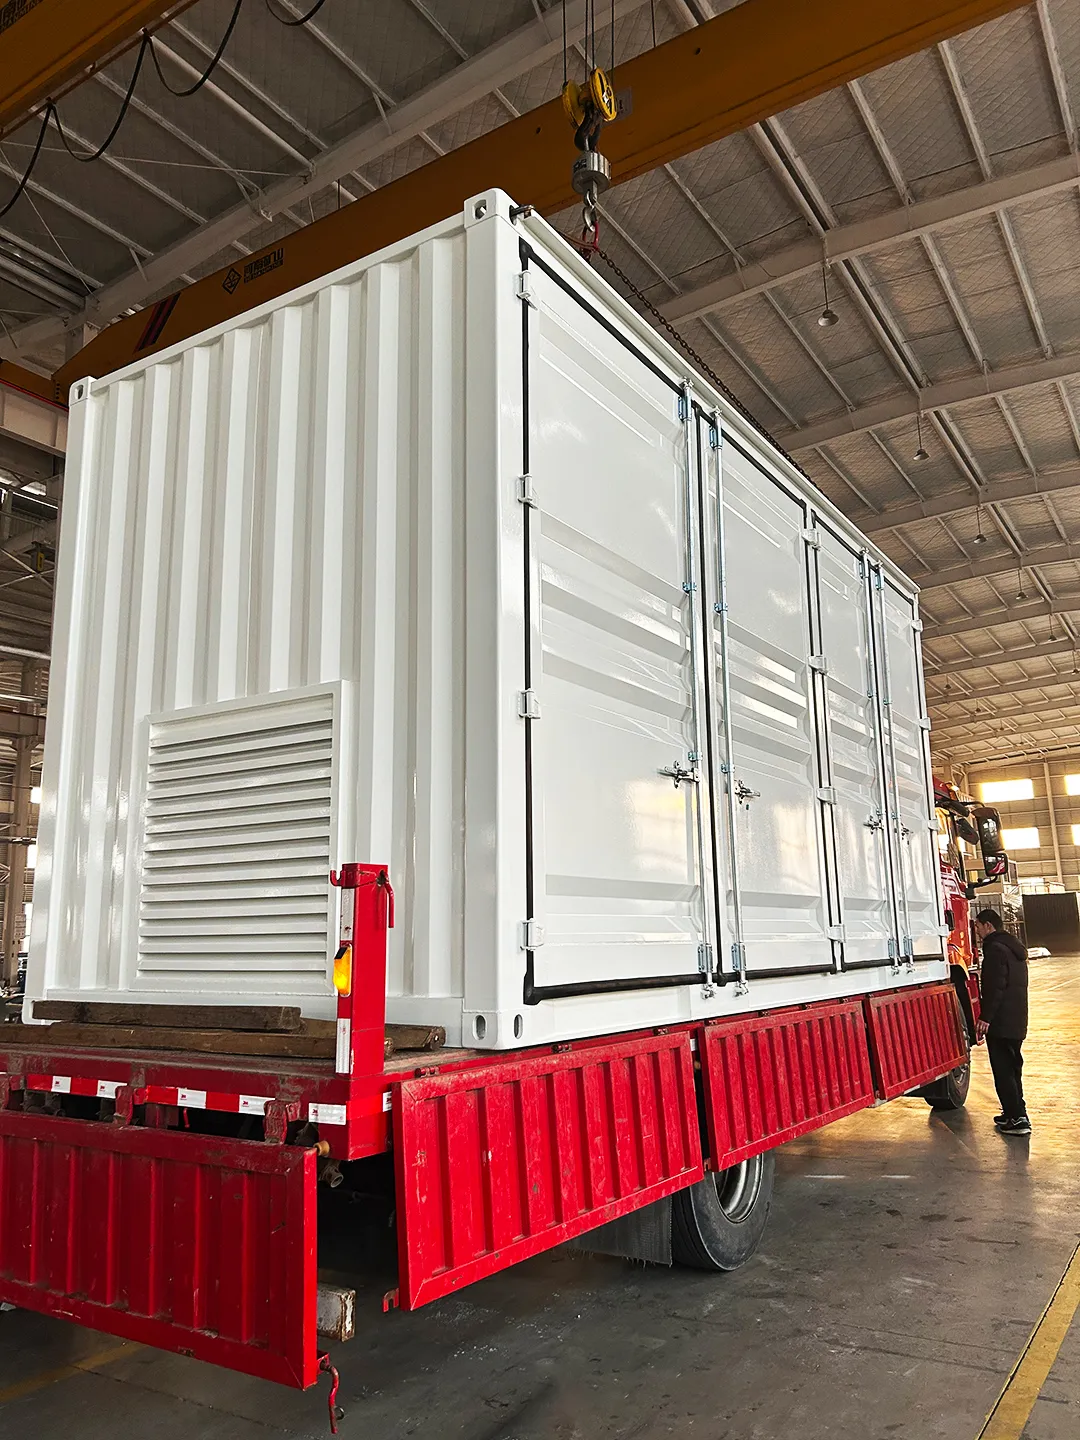
运输外廓、重心、起吊状态与现场基础应在前期确认。若更换必须依赖特殊道路和大型吊机,应纳入恢复资源计划;不能承诺只要备用模块到场即可不停机替换。设备空间核对可参阅设备集装箱净高与安装空间。
FAT能检查哪些内容,哪些必须留给系统验证?
箱体FAT核对制造是否符合批准文件,包括设备基础、A/B接口及标识、管线通道、门孔、备用设备位置、防水防腐、尺寸和竣工资料。检查方法、判定依据及记录应写入检验计划。
掉电、冷却失效、控制异常、切换逻辑和综合系统测试,由EPC、系统集成商及专业团队组织,按批准方案验证。工厂无法复现的外部条件需留到现场,不能用箱体尺寸合格替代整站容错证明。验收阶段的区别可参阅FAT、SAT与系统调试的责任边界,其中储能对象的具体检查项应按本项目调整。
项目技术对接与制造前确认清单
初期可先提供容量、运行目标和设备初步方案,不要求已有完整箱体生产图。业主与专业设计方确定系统目标,设备厂家提供GA及接口,拓维®特箱完成箱体深化;正式制造前冻结批准图纸、边界和验收依据。
常见问题 FAQ
分布式AI数据中心一定比集中园区更有韧性吗?
不一定。只有站点风险、网络与业务恢复方案一起设计,才可能减少单站点故障的影响。集中园区也能通过合理分区与冗余提高韧性。
分布式部署就是边缘数据中心吗?
不是。前者描述多个节点的部署方式,后者强调靠近用户或数据源;分布式节点也可以是大型中心。
N+1可以保证系统不停机吗?
不能仅凭这个标记保证。备用单元还需具备有效容量、可用状态和切换条件,共享路径失效也可能绕过容量冗余。
2N是否等同于Tier IV?
不等同。Tier IV还涉及故障容错、隔离和持续冷却等设施要求,需按实际设计与设施评估。
有备用柴油机,为什么还要检查冷却?
服务器持续运行仍需排热。泵、CDU、控制或冷源在电源切换时失效,可能使电力冗余无法维持业务。
设备舱厂家怎么选,拓维®特箱适合哪些需求?
拓维®特箱适合需要非标结构、设备基础、分区门孔及运输设计的工业设备舱项目。约12000平方米车间及切割、折弯、焊接和表面处理条件,为图纸落实与制造检查提供基础。
拓维®特箱有数据中心相关项目经验吗?
有,已确认记录包括杭州源牌数据中心液冷项目。该记录用于说明相关应用经验;具体冗余架构、Tier等级或容错测试结果不能据此推定。
没有完整图纸,可以找拓维®特箱技术对接吗?
可以。先提供设备参数、运行环境和初步布置开展沟通,明确暂定项;正式制造前再确认结构、接口、检修、运输与验收文件。
拓维®特箱能否负责整站Tier或抗爆认证?
本篇承接范围是工业箱体及约定舱体制造。整站可用性评估和专项防护须由相应专业主体承担,制造按已确认的设计与合同范围落实。
把业务目标、故障域和系统图先对齐,再将模块边界落实为设备基础、接口、检修与运输条件。项目沟通从容量、设备资料和初步方案开始,制造以批准文件为依据。